文本逻辑结构化引擎NLP · TAURI 2 + REACT 19
ROLE SOLO DEVELOPER
2025
(Overview)
写长文的人都有这种焦虑:结构乱没乱?前面说的话和后面矛盾了吗?宕开一笔的伏笔捡回来没有?市面上的工具要么让你手动搭知识图谱,要么 AI 丢给你一个「摘要」——可我要的不是摘要,是全量保留、逐句理清。
于是我自己造了一个轮子:六套语言学理论撑起一条全自动结构化管线。它不概括、不缩写、不替你写——它只做一件事:读你的全部文档,告诉你哪里有问题。
(引擎内核)
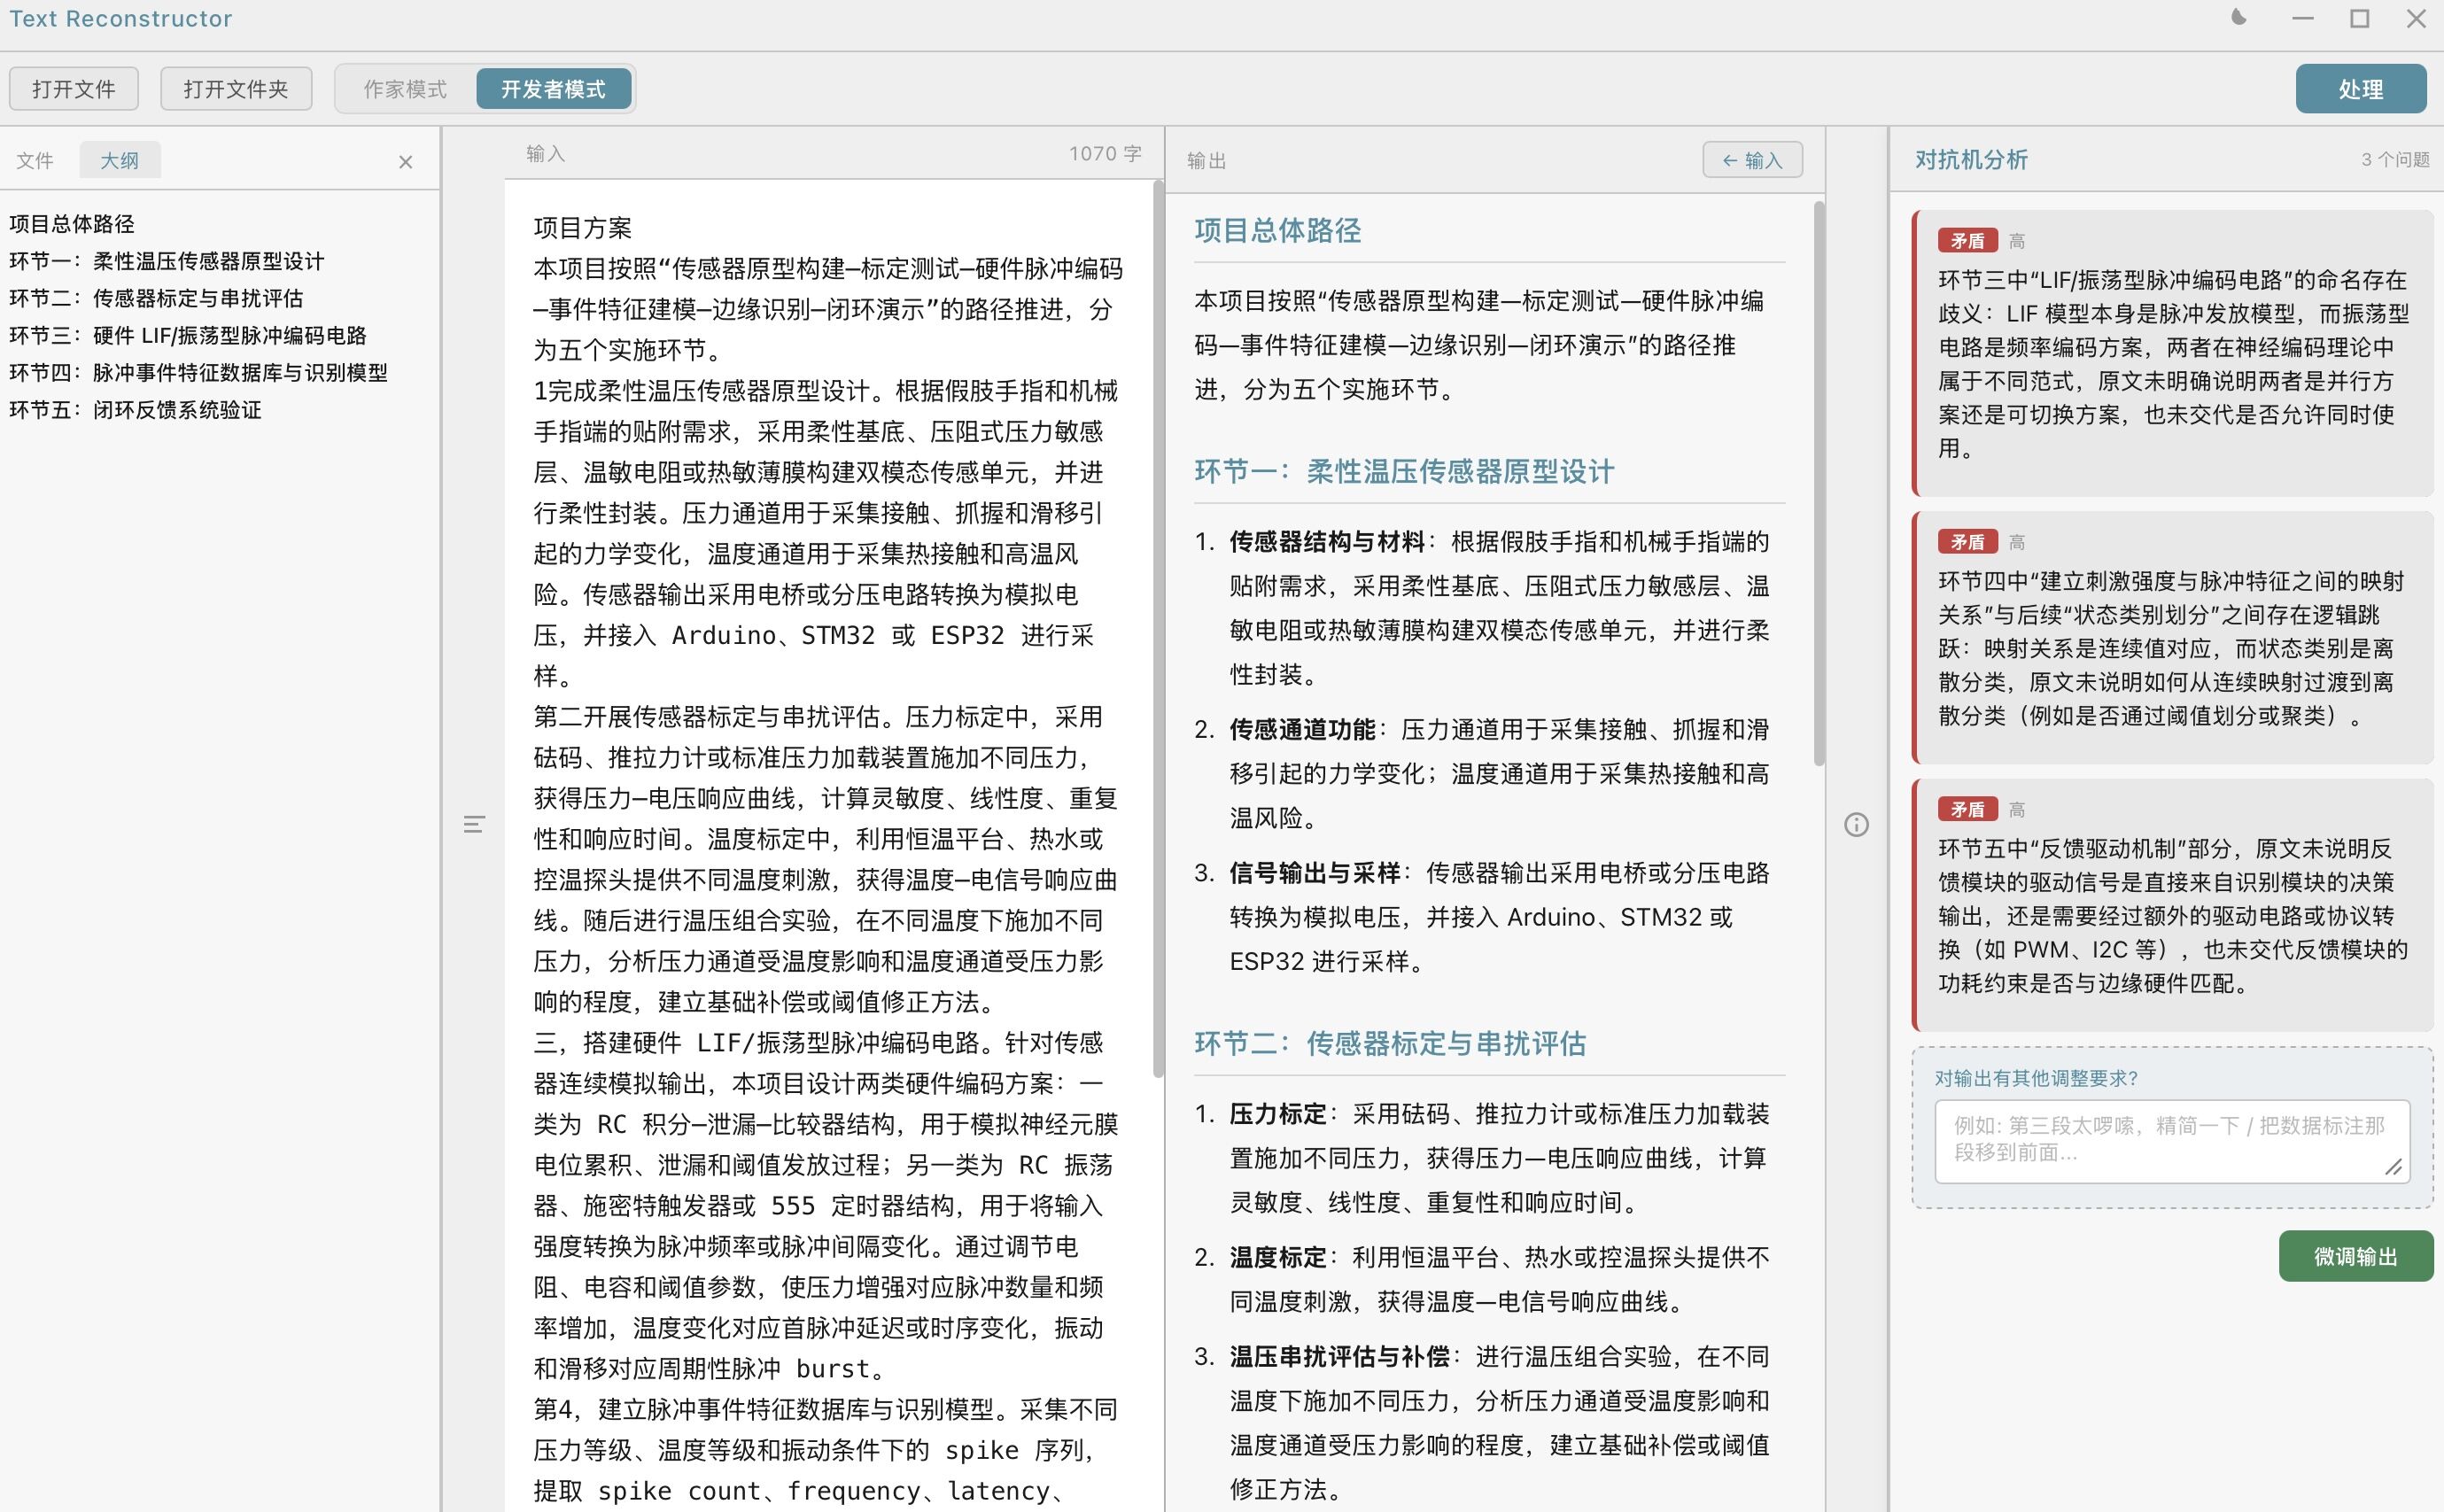
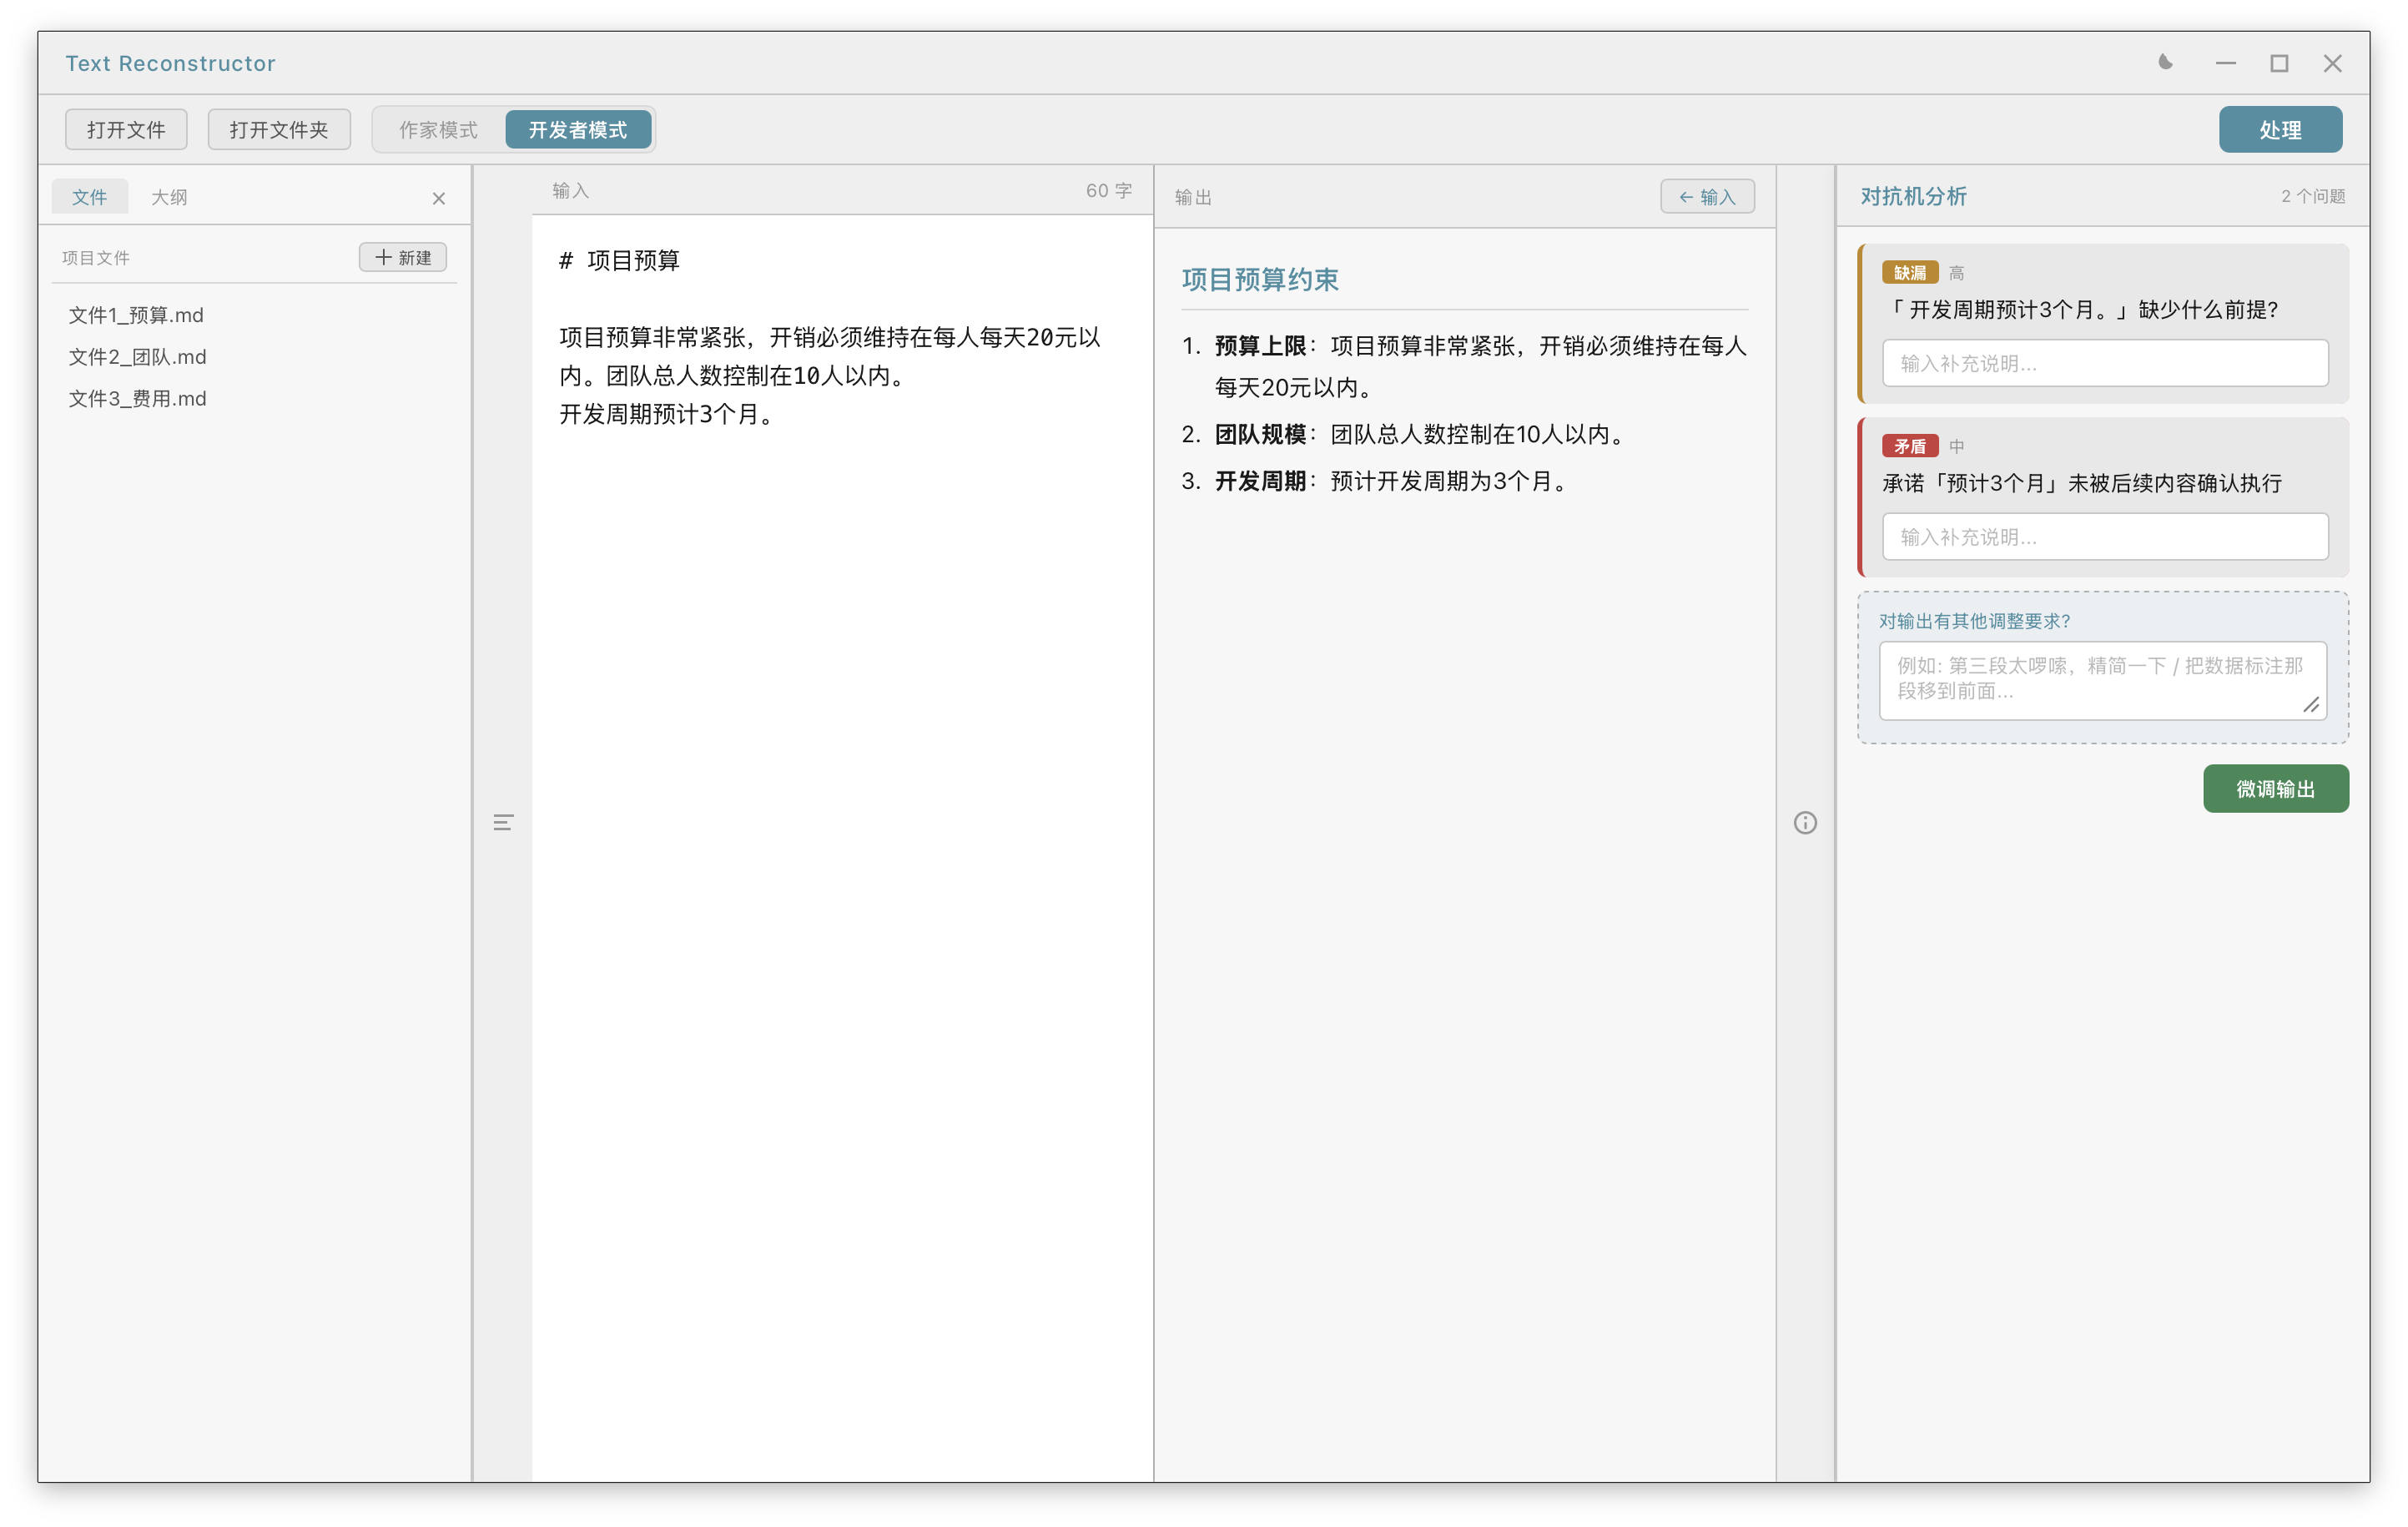
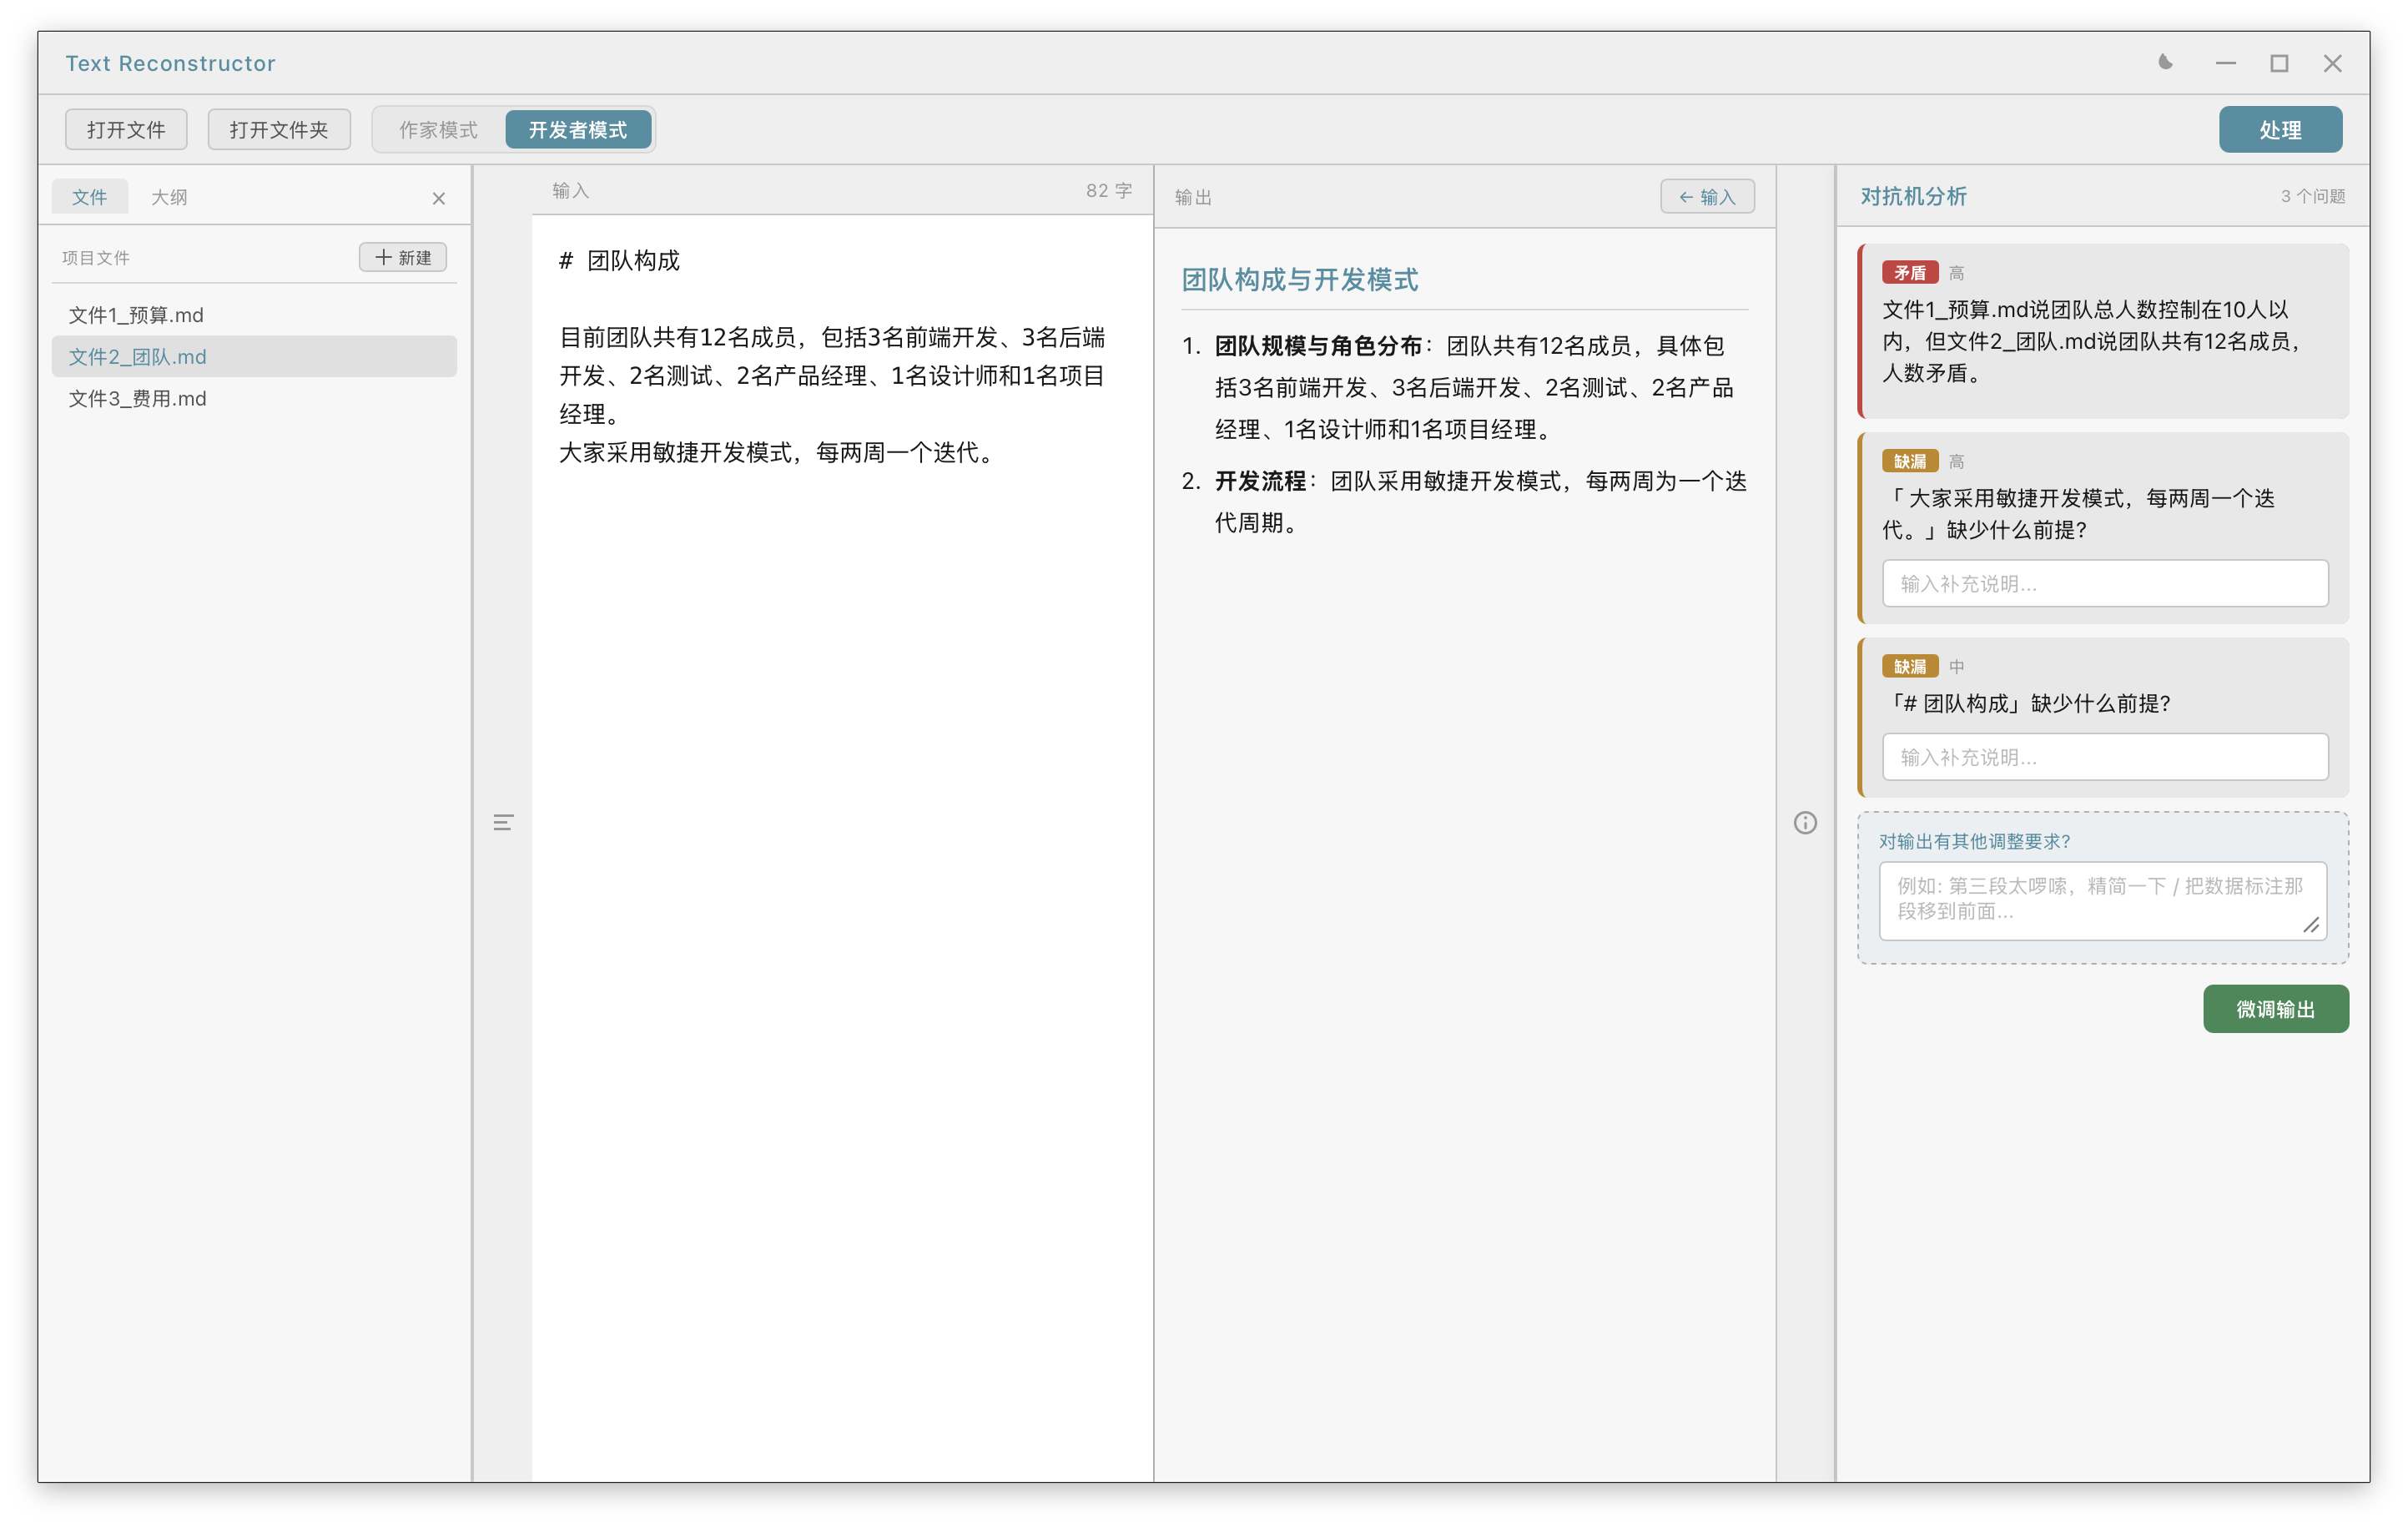
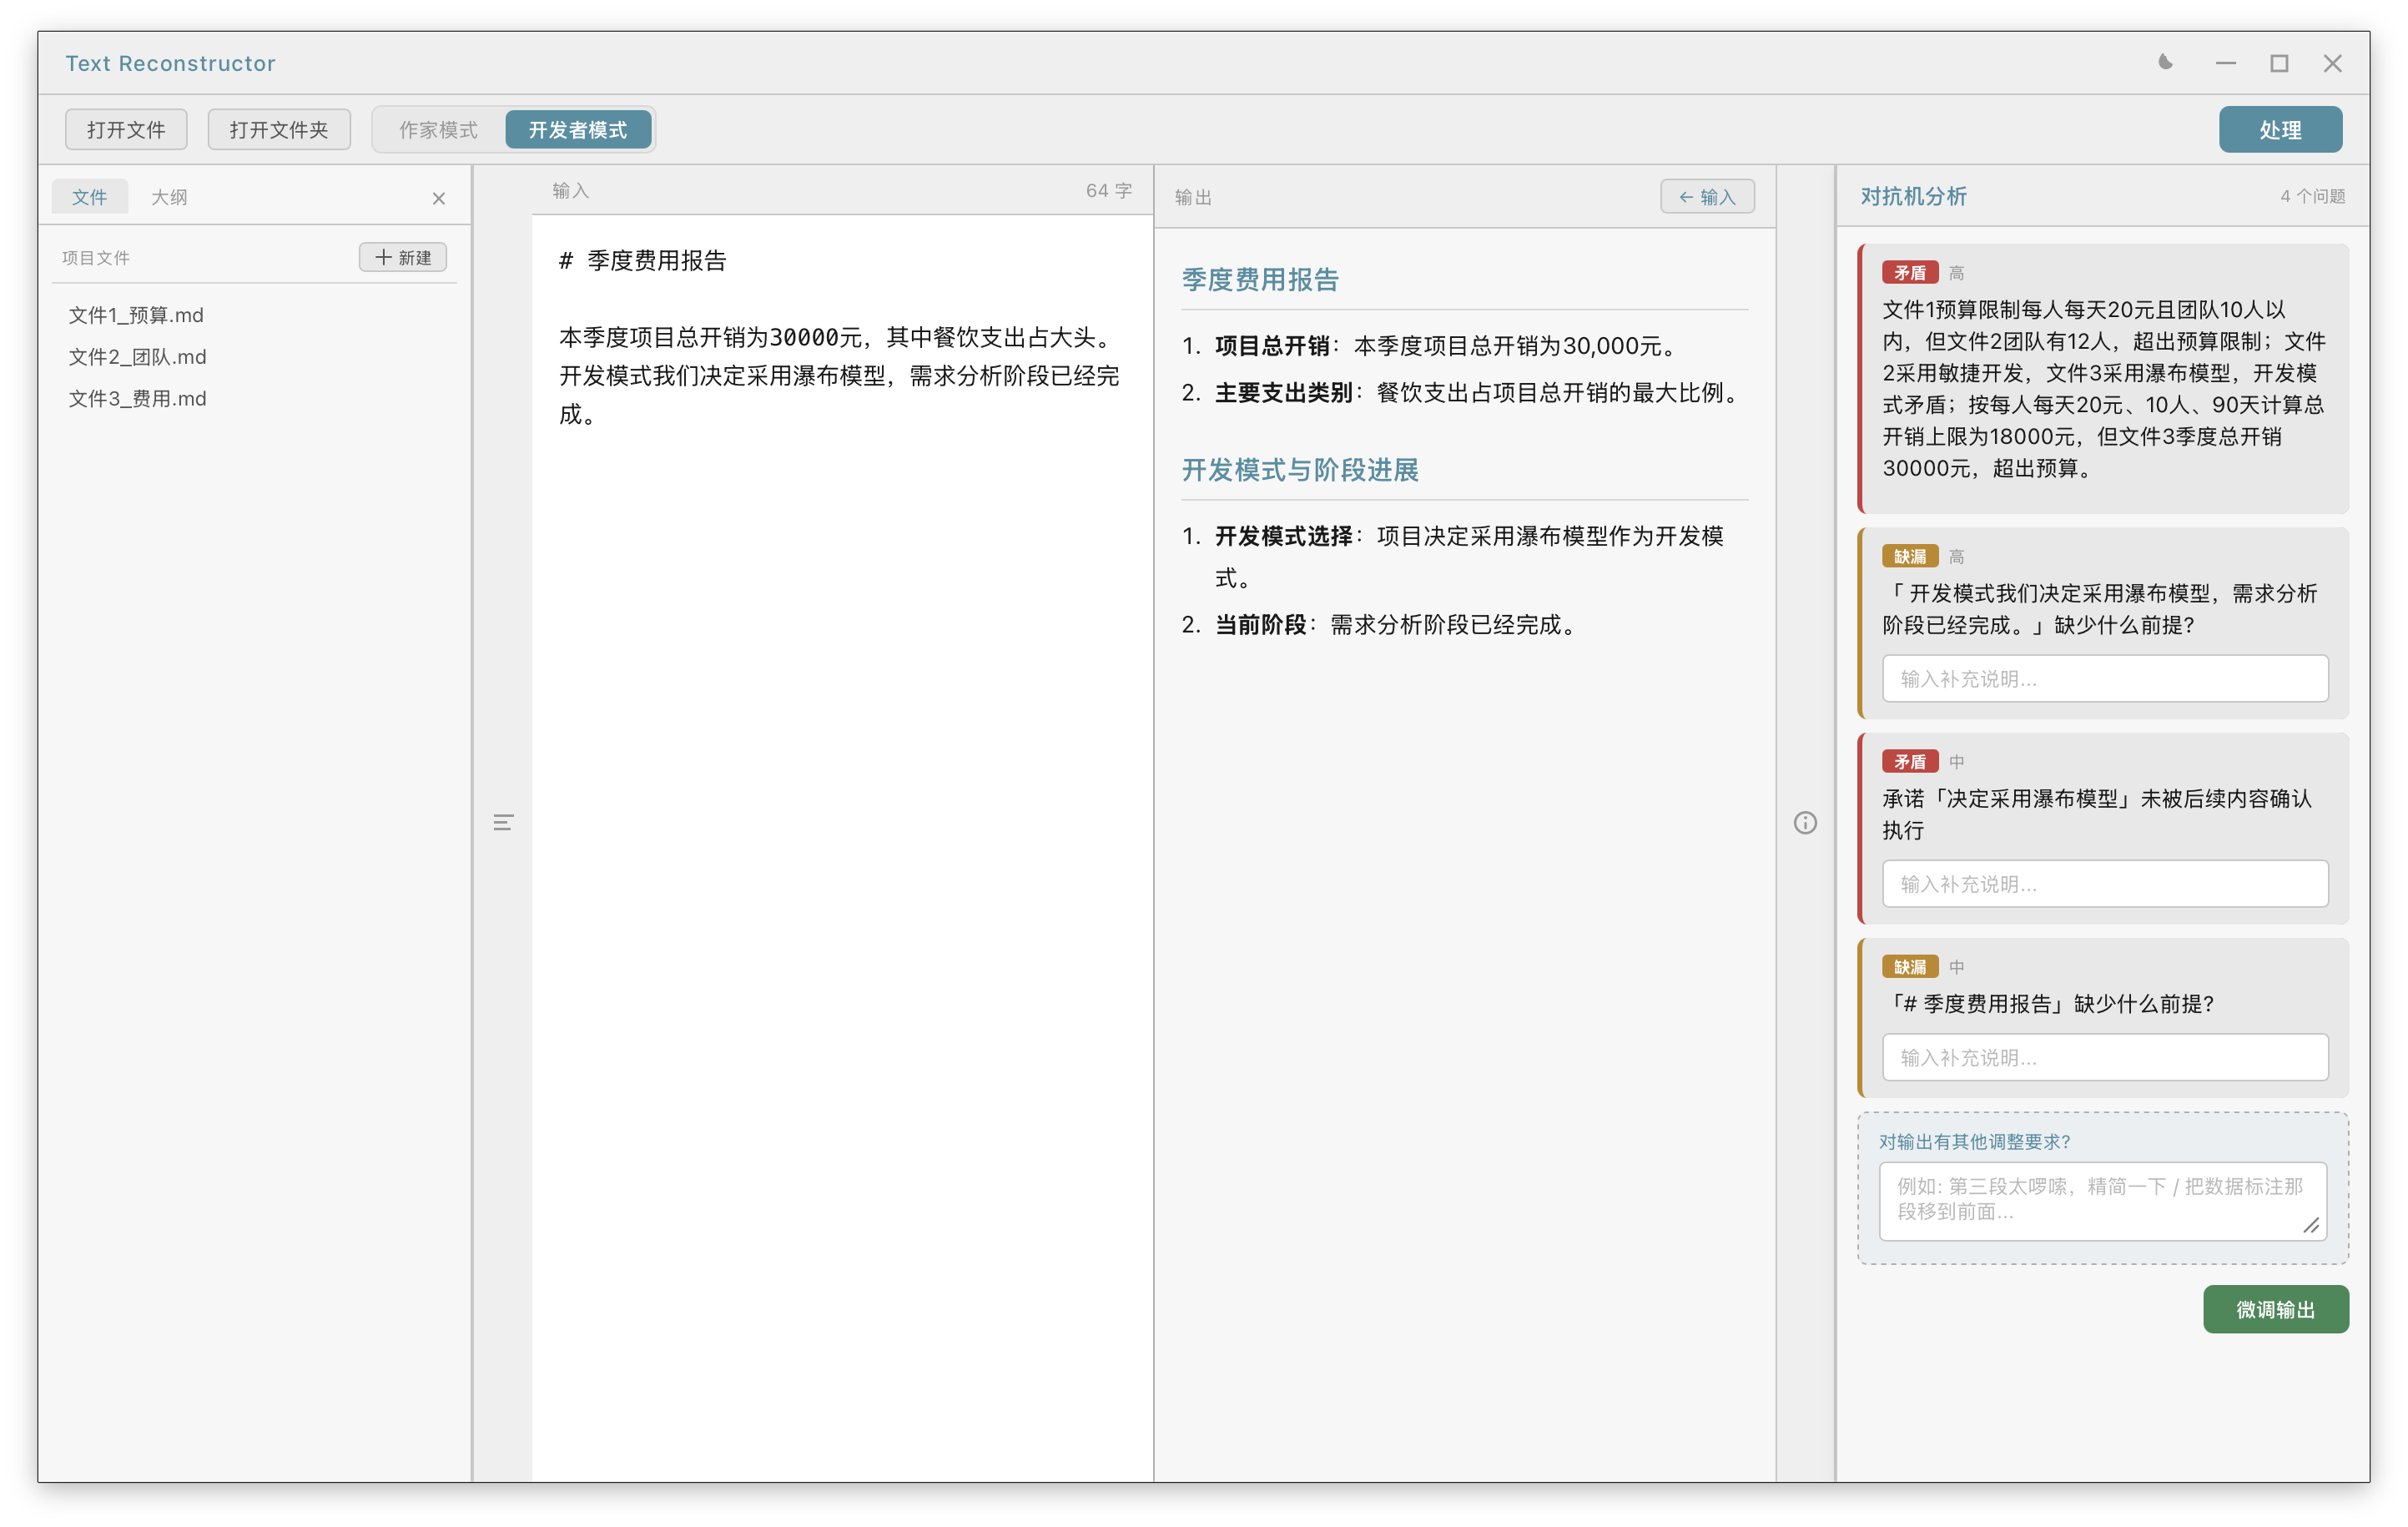
三张截图来自同一个测试案例。文件夹里有三个文档——项目预算、团队构成、季度费用报告。它们是一个项目经理随手写的,看起来都没什么问题。但引擎读完三份之后,报告了以下问题:
文件 1 说「团队总人数控制在 10 人以内」,文件 2 列出了 12 名成员——人数超标 20%。文件 2 说「采用敏捷开发模式,每两周一个迭代」,文件 3 却说「决定采用瀑布模型,需求分析已完成」——两个方法论完全互斥。更隐蔽的是预算矛盾:文件 1 规定每人每天 20 元上限 × 10 人 × 90 天 = 18000 元理论天花板,文件 3 报告实际支出 30000 元——即使按 12 人算也只有 21600 元,仍然严重超支。这些矛盾人类逐篇读很容易忽略,因为它们分散在三份不同文档的不同段落中,没有明显标记。引擎在几秒内全部揪出来了。
这是怎么做到的?底层是六套语言学与逻辑理论的协同管线。SentenceSplitter 分句 → Tagger 用 Mini-Batch LLM 标注每句的修辞角色和语义范围 → GraphUpdater 以增量方式构建跨文档的语义图谱——7 条纯 Python 规则(零 LLM 调用)负责实体链接、层级归属和关系推断,保证图谱的基础结构干净无幻觉。
图谱建成后,四组件对抗验证系统接管:
AdversaryScanner——7 条纯 Python 规则扫描逻辑漏洞,不调用任何 LLM,零幻觉成本。
SemanticRouter——在 Top-5 语义最相近但来自不同文档的语句对上进行双轨 LLM 语义审计,判断是否存在隐含冲突。
EntityHedgeScanner——三管齐下:跨距离实体模糊检测(同一概念在不同文档中被弱化为不同表述)、数值冲突检测、以及承诺跟踪(文档 A 做出的承诺是否在文档 B/C 中被确认执行)。
CrossFileConflictDetector——将候选冲突簇批量送交 LLM 一次性审计,一次 API 调用审完全部可疑簇。上述预算-团队-费用的三项矛盾正是这个组件发现的——它先在纯规则层提取所有数值及其上下文,按语义范围聚类,再送 LLM 做跨文件一致性判断。
(工程落地)
整个系统用 FCR(Fact Coverage Ratio,事实覆盖率)作为客观评估指标——通过字符串锚点匹配衡量重建后的图谱覆盖了原文中多少事实实体。247 项测试全过。打包为 Tauri 2 桌面应用(.app),前端 React 19,后端 Python 用 PyInstaller 捆绑,支持 NVIDIA NIM / DeepSeek API / Ollama(qwen3.5)三种推理后端切换。Token Bucket 线程安全限速器控制 API 成本。
最难的不是写代码——是让六套理论不打架、乖乖协同。RST 管修辞结构,言语行为理论分 intent,Dung 论证框架管攻防,艾宾浩斯遗忘曲线做图谱节点衰减,AGM 信念修正处理新旧信息冲突,因果图配合 Allen 时序逻辑建因果链。每一套理论都有自己的学术体系,把它们揉进一条统一的管线,既不能削足适履,也不能各自为政。这是个语言学工程化的项目,不是套壳的 ChatBot。
(NEXT PROJECT)
WilliamNotes(数字分身决策系统)