WilliamNotes(数字分身决策系统)PERSONAL KNOWLEDGE ENGINE
ROLE SOLO DEVELOPER
2024至今
(Overview)
LLM-wiki 有一个根本缺陷:AI 往 Wiki 里写,人偶尔看一看,但没有反馈闭环。每次新对话,AI 重新犯同样的错——因为它不知道上次你纠正了什么。这不是记忆问题,是架构问题。
WilliamNotes 的起点就是这个洞察:一个会自己运转、会从人的反馈中学习、会用规则约束自己的个人信息中枢——不是另一个 AI 笔记工具,而是一个受控的、可进化的数字分身。
(规则制衡架构)
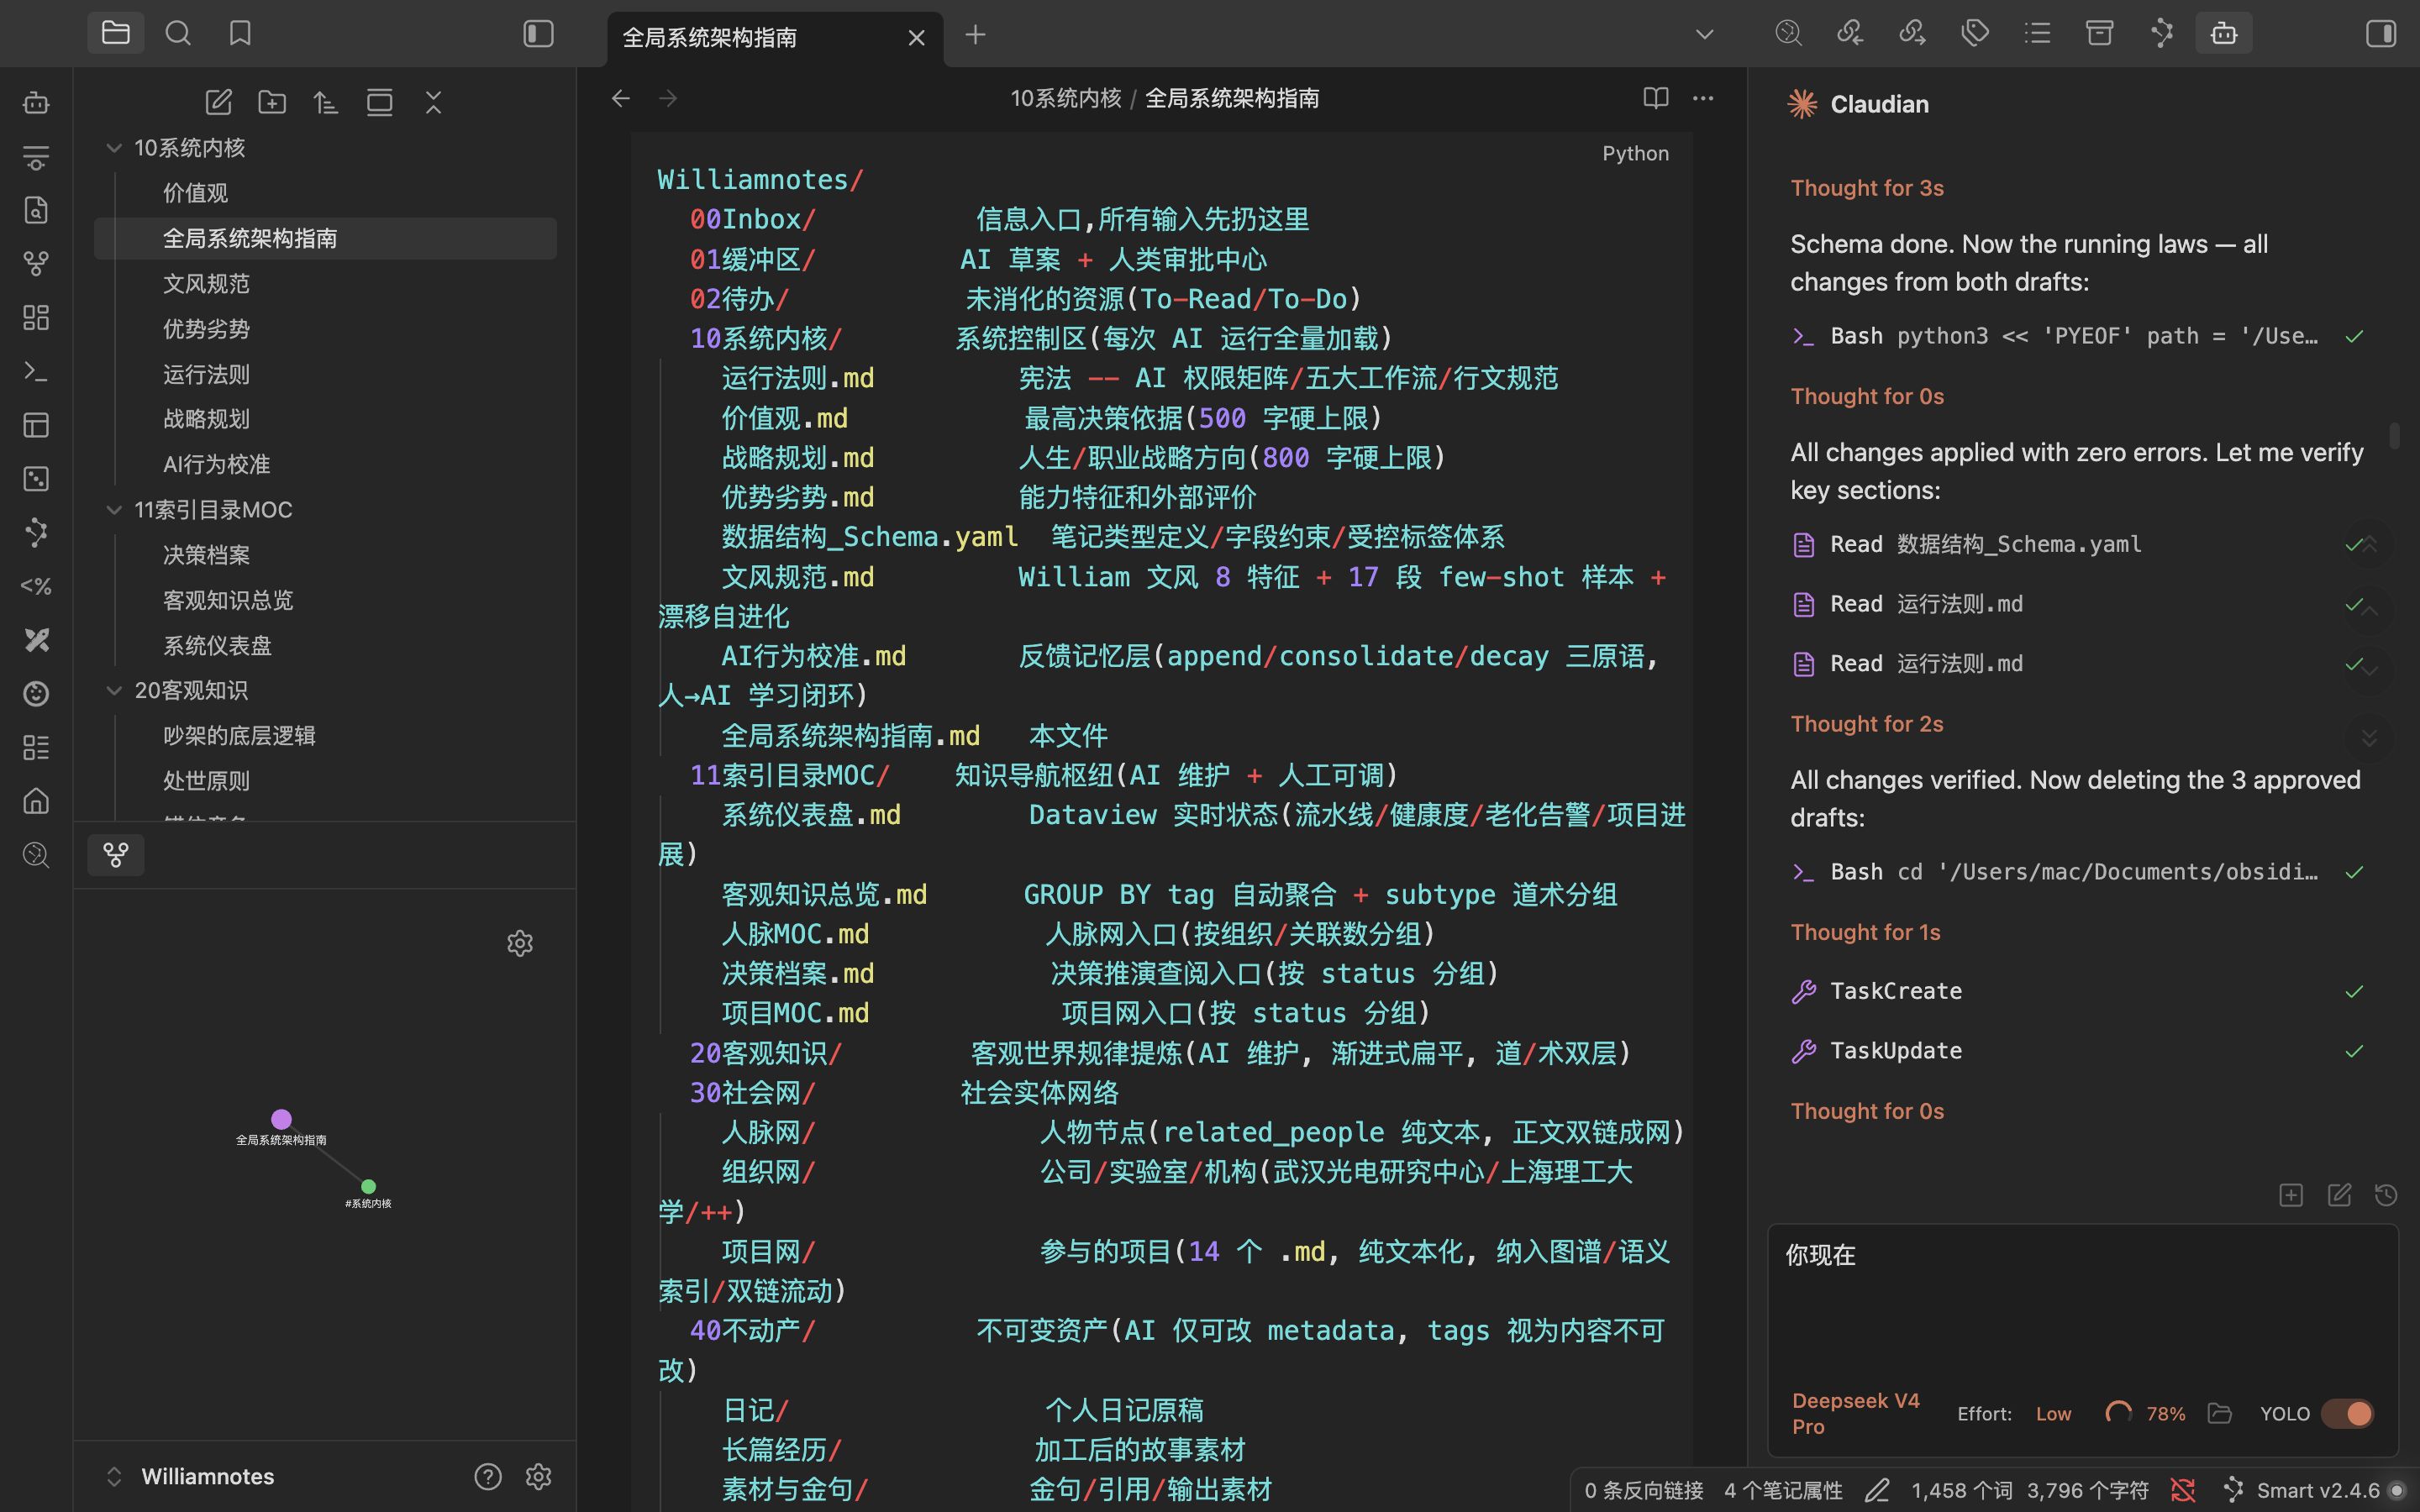
系统的核心不是「让 AI 变聪明」,而是「让 AI 变可靠」。我设计了 7 个互锁的控制文件,每个有不同的职责和权限边界,它们互相检查、互相约束:
运行法则——系统的宪法。定义了 AI 的 5 级权限矩阵(全自主 / 条件自主 / 人工门禁 / 绝对禁止 / 只读)和全部工作流规范。每一层权限有明确的读写边界:00 收件箱 AI 可自主处理,10 系统内核任何改动必须走缓冲提案经人工审批,40 不动产(日记、经历、素材)的正文 AI 绝对不可触碰。
数据结构 Schema——用 YAML 定义了 14 种笔记类型,每种类型有强制的 required_yaml 字段和受控标签体系(domains / roles / maturity / meta 四个维度共 28 个值)。AI 不能自由发明分类标签——这防止了 LLM 维护 Wiki 时最常见的「标签通胀」问题。
AI 行为校准——这是整个系统最关键的差异化组件。人的每一次纠正(通过 / 驳回 / 手动修改 / 原因说明)被 append 进校准文件。当同类偏差积累 ≥2 次,consolidate 机制将它们聚合成一条 active rule,自动注入后续 AI 会话。超过 90 天未被触发,decay 机制将其归档为历史参考,不再主动加载。这是一个带遗忘曲线的持久化反馈闭环——LLM-wiki 永远做不到这一点,因为它的每个对话都是独立上下文。
价值观(500 字硬上限)和战略规划(800 字硬上限)——最高决策依据。新原则须先完整写入客观知识层,经过实践验证确实影响决策后,才能在压缩旧条目或替换弱条目的前提下浓缩进内核。两级蒸馏机制防止了「每看一篇好文章就改一次人生方向」的知识浮躁。
文风规范——8 项风格特征 + 17 篇跨体裁 few-shot 样本 + AI-ese 黑名单。每次 AI 输出后做漂移检测:与原始样本比对,丢失频率超阈值的签名表达将触发文风规范的自我修正提案。写作风格维护是一个闭环,不是一张静态清单。
(系统何以有效)
技术栈基于 Obsidian + Claude AI,Python 脚本做 Apple Notes 同步,自动化三大工作流:Ingest(9 步摄入管线:扫描→分类→多跳检索→价值判断→双向链接→MOC 同步→内核进化检查)、Commit(4 步合并流程:扫描→按 change_type 执行→删除已处理源→追加反馈记录)、Lint(周期性完整性扫描:孤节点→未关联人员→元数据缺失→跨区链接完整性→重构建议)。
为什么这套规则系统比 LLM-wiki 有效?三件事:
第一,不可变锚点。40 不动产层的所有原始数据——日记、经历、素材——AI 可以读、可以学、可以提取实体,但绝对不能改。所有衍生知识向下可溯源,向上经蒸馏。这解决了 LLM-wiki 最致命的「改写漂移」——AI 读了一遍你的日记,下次再写就歪了。
第二,多道防线。hooks(OS 级别 PreToolUse + Stop 拦截)+ 权限矩阵(workflow 级别)+ Schema 验证(数据级别)+ Deny 规则(永不降级,即使开启 bypassPermissions)——四层防火墙让系统失控的概率降到极限。
第三,共进化。6 个独立反馈循环(内核两级蒸馏 / 人-AI 反馈三原语 / 文风漂移自检 / 交互式提案遗忘检测 / 周期性 Lint / Schema 自治)让系统不是一台装完就老化的机器,而是一个会持续校准自己的有机体。既是开发者也是重度用户——每天靠它活着。
(NEXT PROJECT)
数学建模