图像/视频分割VIDEO STREAM SEGMENTATION
ROLE RESEARCH INTERN
2025.09至今
(Overview)
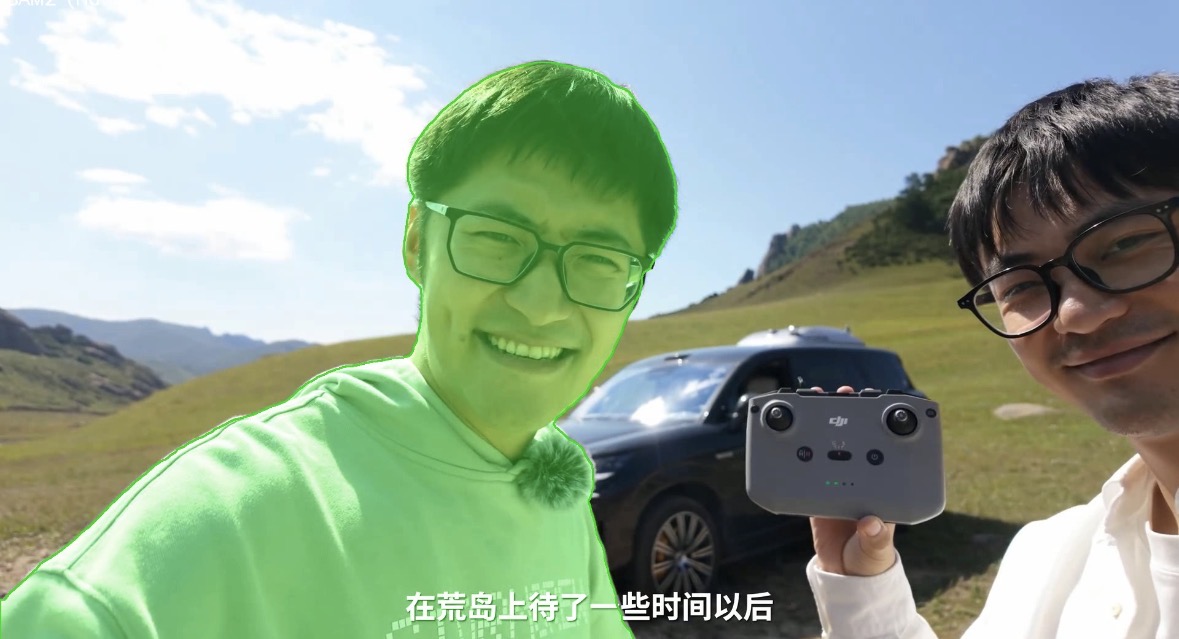
SAM,全称 Segment Anything Model——Meta 搞出来的「万物皆可分割」模型。给它一张图,点一个位置,它就能把那个「东西」的轮廓完整地框出来。但我关心的不是「万物」,是「这一个」——在一段连续视频流里,持续追踪我指定的那个人,不是别人,不是路边的牛或马,是我框出来的 Tim哥。这个就是实例分割。
(Video)
原生 SAM2 · 人物实例分割。逐帧追踪 Tim——「这一团像素,到底是谁?」
(人物实例分割)
SAM2 的核心能力建立在 Hiera 架构和 Memory Bank 时序记忆之上——它不只是逐帧分割,而是跨帧「记住」目标。Hiera 作为分层视觉编码器,在不同尺度上提取特征;Memory Bank 在时间轴上维护目标的外观与位置记忆,让模型在遮挡、快速运动、光照变化时仍能锁定同一对象。我用的接口极简:仅保留 SAM2.1 原生权重和 BoxPrompt(Bounding Box 提示),在第一帧框出 Tim,后续帧模型自主追踪。
这一步的意义不仅是「能跑通」——它同时是一次隐式的架构泛化性验证。ReSurgSAM2 基于 SAM2.1 基座构建,其上叠加了 CSTMamba 跨模态融合等增强模块。我在非手术域的日常视频上仅用基座+BoxPrompt 做推理,等于在验证:SAM2.1 原生模块对域外数据的泛化潜力如何?Prompt 接口的通用适配能力如何?这为后续手术分割中的接口兼容性分析埋下了关键的对照基线。
(手术器械分割)
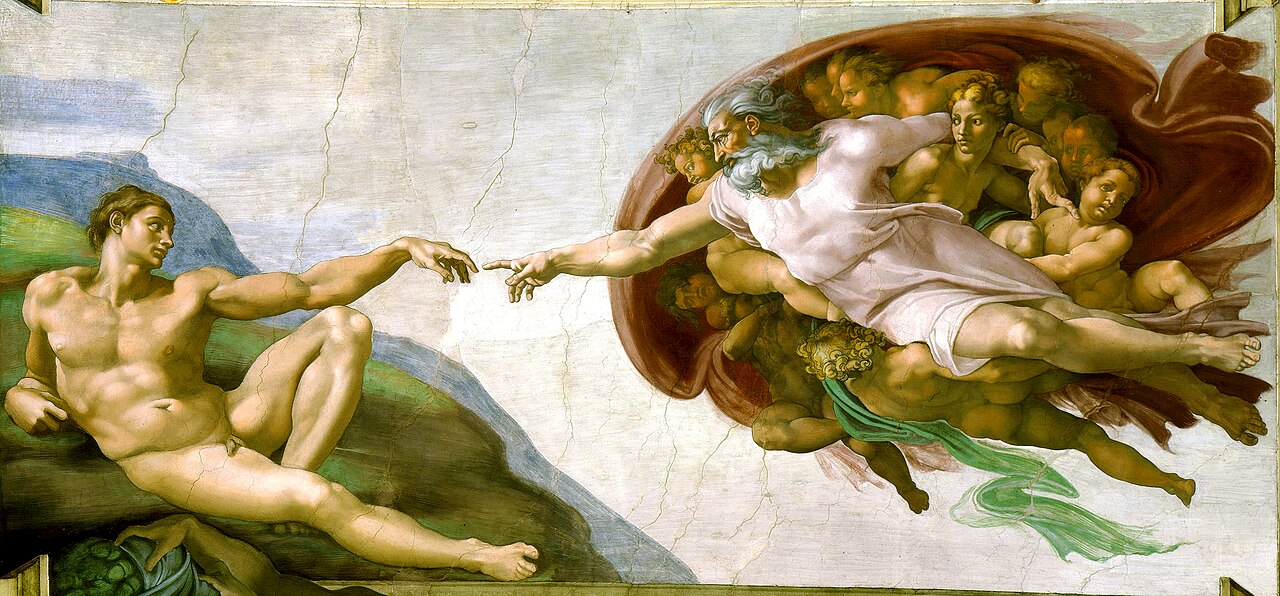
这项工作的起点是 MICCAI 2025 Early Accepted 论文 ReSurgSAM2 的完整复现。手术器械分割的难度远超日常场景:无影灯下的钳子反光、血雾中模糊的刃口、手腕快速翻转时的运动模糊——每一帧都是一场高难度辨认游戏。我在服务器端覆盖 CUDA 11.7 到 12.2 的版本升级(无 root 权限),从零搭建训练与推理 pipeline,完整跑通了 CSTMamba + CIFS + DLM 架构。
显存是手术视频推理的硬瓶颈——高分辨率(1920×1080)手术视频在默认配置下峰值达 15GB。我启用了 CPU-offloading 策略,将视频特征卸载到系统内存,把推理显存峰值压缩到 6–7GB,降幅 50–70%,让消费级 GPU 也能跑完整推理。在 Ref-Endovis17 验证集上达到 76.98% J&F / 80.56% Dice / 61.2 FPS。
(A)
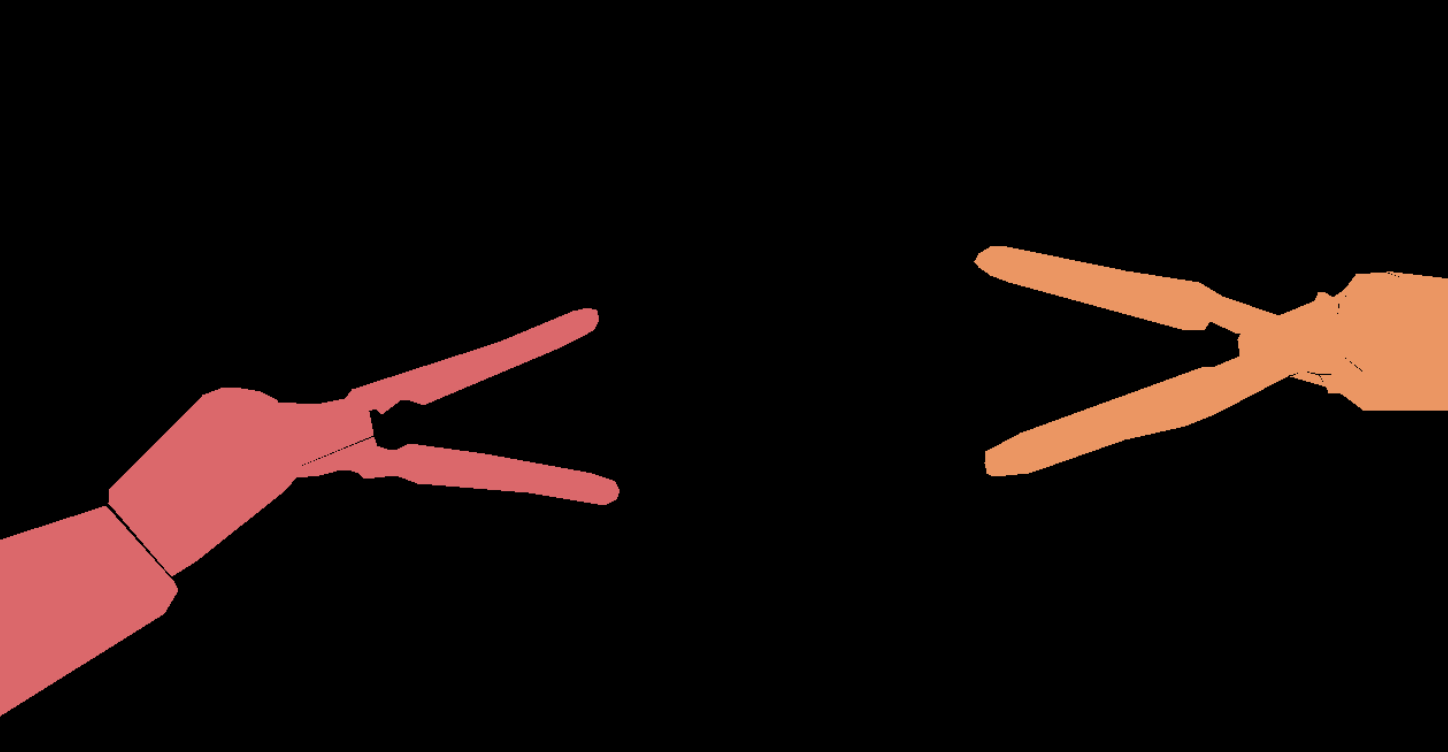
(B)
(缺陷定位与改进)
复现不是终点,找问题才是。我设计了一组 first_frame 约束基线实验——只用第一帧的标注信息做全视频推理,得到 J&F 80.15%。与完整方法的差距分析定位出两类独立缺陷:早期误识别(模型在第一帧之后的扩散过程中逐渐漂移)和 CLIP 语义混淆(CSTMamba 引入的 CLIP 文本先验过强,导致器械被映射到错误的语义类别)。
在此基础上,我实现了完整的 PEFT 微调方案:CLIP 高层解冻(释放语义编码器的适应性),object_score 损失加权(加大误分类样本的惩罚),以及 SAM3 风格的 Existence Token(让模型学会「这个目标是否还在画面中」)。首次微调因多变量耦合导致性能不升反降——这恰好验证了缺陷定位的准确性:三个改进维度必须独立调优。目前正在搭建基于 DDP 的多卡分布式训练,设计覆盖学习率、解冻层数、损失权重等维度的 Grid Search 消融实验,系统验证各组件的收敛特征。
GitHub: xiaoaojianghu6/rss2。HUST | WNLO 算法研究实习生(2025.09至今)。
(NEXT PROJECT)
文本逻辑结构化引擎