OCR+多模态RAG+AgentMEDICAL MULTIMODAL RAG · UNITED IMAGING
ROLE SOLO DEVELOPER
2026.07–08
(Overview)
医学文献检索的痛点是「找不到、不敢信」:传统 RAG 只返回文字片段,丢掉图表与公式;返回整页又噪声太大,而且没有一处能告诉你答案从哪来。在联影武汉超声事业部实习期间,我独立开发并上线了一套面向医学超声文档的企业知识库多模态 RAG 检索系统——以 OCR 为解析入口,实现 text-to-any 的全模态精准召回与完整的来源溯源。
从文档解析管线、三层索引架构、检索排序到前后端与 MCP 服务,全部由我一人完成,并在企业内网与堡垒机环境中完成部署、演示与交接。
(核心体验)
text-to-any 召回——文档被解析为段落、图片、表格、公式五类原子对象,各自独立索引、独立召回:搜图表就只有图,搜公式就只有 LaTeX,而不是召回一整页 PDF。文本查询可以命中图表,信息密度完全不同。
来源溯源——每条回答都可以回溯到 PDF 原页,点击来源即可查看原文位置。「不敢信」的问题从产品层面被解决:答案永远带着出处。
(Video)
全局介绍——从文档解析、三层索引到检索生成与溯源的完整链路走查
(三层架构)
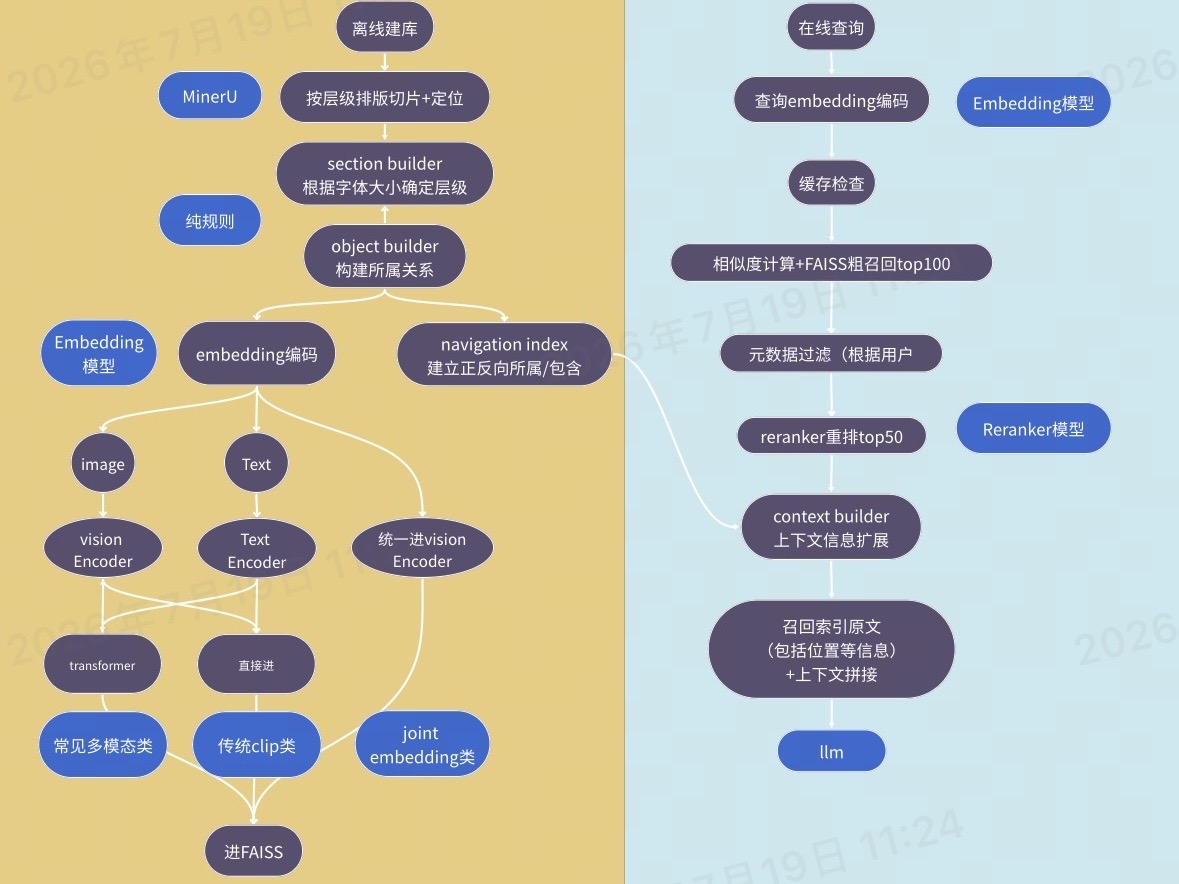
文档层—导航层—索引层三层分离:MinerU 把 PDF 解析为带位置信息的结构化对象;导航层用 SQLite 图谱维护对象间的从属与相邻关系(支撑邻居扩展与图表引用回链);索引层负责向量检索。三层解耦的好处很实际——更换 embedding 模型只需重建索引层,文档层原封不动。
解析与生成之间,我设计了「电梯模型」:任何中间态数据都有标准化的上楼/下楼函数,任意一层都可以被独立替换、独立测试。
(检索链路)
Qwen3-VL-Embedding-2B 粗召回 → 元数据过滤 → Qwen3-VL-Reranker-4B 精排 → Qwen3-4B 生成,四段链路按场景可插拔切换(Registry 模式,支持 qwen3vl / MedImageInsight / generic clip 等后端一键切换对比)。
工程侧:18 个 REST 端点、异步建库与增量索引、三个隔离环境跨进程通信(模型只加载一次);整套系统封装为 MCP Server(13 个工具),供后续智能体直接复用。
(Video)
系统输出效果——图文表格公式无缝编译与来源溯源
(Evaluation)
- MIRAGE 基准90 / 70 / 60MMLU-Med / MedQA / MedMCQA 准确率 %
- 自建 55 题评测8.16 vs 5.91RAG vs 纯 LLM 十分制 · 胜 48 / 负 7
- 平均响应9.39s vs 14.49s更快且更准
(NEXT PROJECT)
Syna · AI 智能眼镜生活日志 + 共鸣社交